Marketing Analytics
Di Balik CORE: Memilih Toko yang Tepat untuk Program Loyalty
Cerita pengembangan modul optimasi CORE: membaca potensi toko dari data transaksi, mempertimbangkan anggaran, dan menguji kualitas seleksi pada periode berikutnya.
Daftar peserta program loyalty terlihat sederhana: nama toko, kategori, target pembelian, dan reward. Namun, setiap nama di dalamnya mewakili keputusan tentang ke mana anggaran dan perhatian tim akan diarahkan.
Dalam proyek CORE, persoalan optimasi program loyalty membawa saya pada pertanyaan yang sangat praktis: dari ribuan toko dengan karakter berbeda, toko mana yang paling layak dipilih ketika kapasitas program terbatas?
Toko dengan pembelian terbesar tentu menarik. Tetapi ada juga toko yang lebih kecil, rutin bertransaksi, dan menunjukkan performa kuat dibandingkan toko lain di kelompoknya. Sementara itu, toko yang sudah lama menjadi peserta belum tentu masih memiliki pola pembelian yang sama.
Bagian ini menjadi salah satu fondasi CORE, atau Commercial Optimization & Retention Engine. Saya mengembangkan metode untuk membaca potensi toko dan menyusun rekomendasi peserta yang alasan pemilihannya bisa ditelusuri.
Ketika pengetahuan lapangan perlu dipertemukan dengan data
Tim sales memiliki pengetahuan yang sulit digantikan oleh laporan transaksi. Mereka memahami hubungan dengan pemilik toko, kondisi distribusi, dan situasi pasar setempat. Tantangannya muncul ketika informasi tersebut harus diterjemahkan menjadi pilihan yang konsisten untuk ribuan toko.
Tanpa kriteria yang sama, dua toko dengan performa serupa bisa memperoleh perlakuan berbeda. Toko yang sering berinteraksi dengan tim lebih mudah diingat, sedangkan toko potensial yang belum masuk daftar lama dapat terlewat. Saat komposisi peserta dipertanyakan, alasan pemilihannya pun belum tentu terdokumentasi.
Saya ingin memberi dasar pembanding untuk percakapan itu. Rekomendasi berbasis data memungkinkan tim melihat kembali pilihannya: apakah toko ini memang kuat, apakah ada kandidat yang belum diperhatikan, dan apa konsekuensinya terhadap keseluruhan program?
Studi yang mendasari modul ini mencakup 832.906 catatan transaksi dari 18.551 toko di tiga wilayah distribusi di luar Jawa–Bali. Data tersebut mencakup Januari 2025 hingga Maret 2026. Angka ini adalah cakupan studi seleksi loyalty, yang merupakan satu bagian dari pengembangan CORE.
| Komponen studi | Cakupan | Perannya dalam analisis |
|---|---|---|
| Data awal | 832.906 catatan transaksi; 18.551 toko | Membentuk riwayat perilaku, bukan jumlah peserta yang dipilih |
| Unit keputusan | Satu toko | Setiap toko menjadi kandidat masuk atau tidak masuk program |
| Unit agregasi | Toko × bulan | Menyatukan transaksi yang frekuensinya berbeda |
| Kelompok toko | Bronze, Silver, Gold, Platinum, Super Platinum | Pembanding performa dan acuan batas komposisi |
| Periode penyusunan final | Januari–Desember 2025 | Menghitung fitur, skor, dan rekomendasi |
| Periode evaluasi berikutnya | Januari–Maret 2026 | Memeriksa performa setelah periode penyusunan selesai |
Membaca potensi toko dari kebiasaan belanjanya
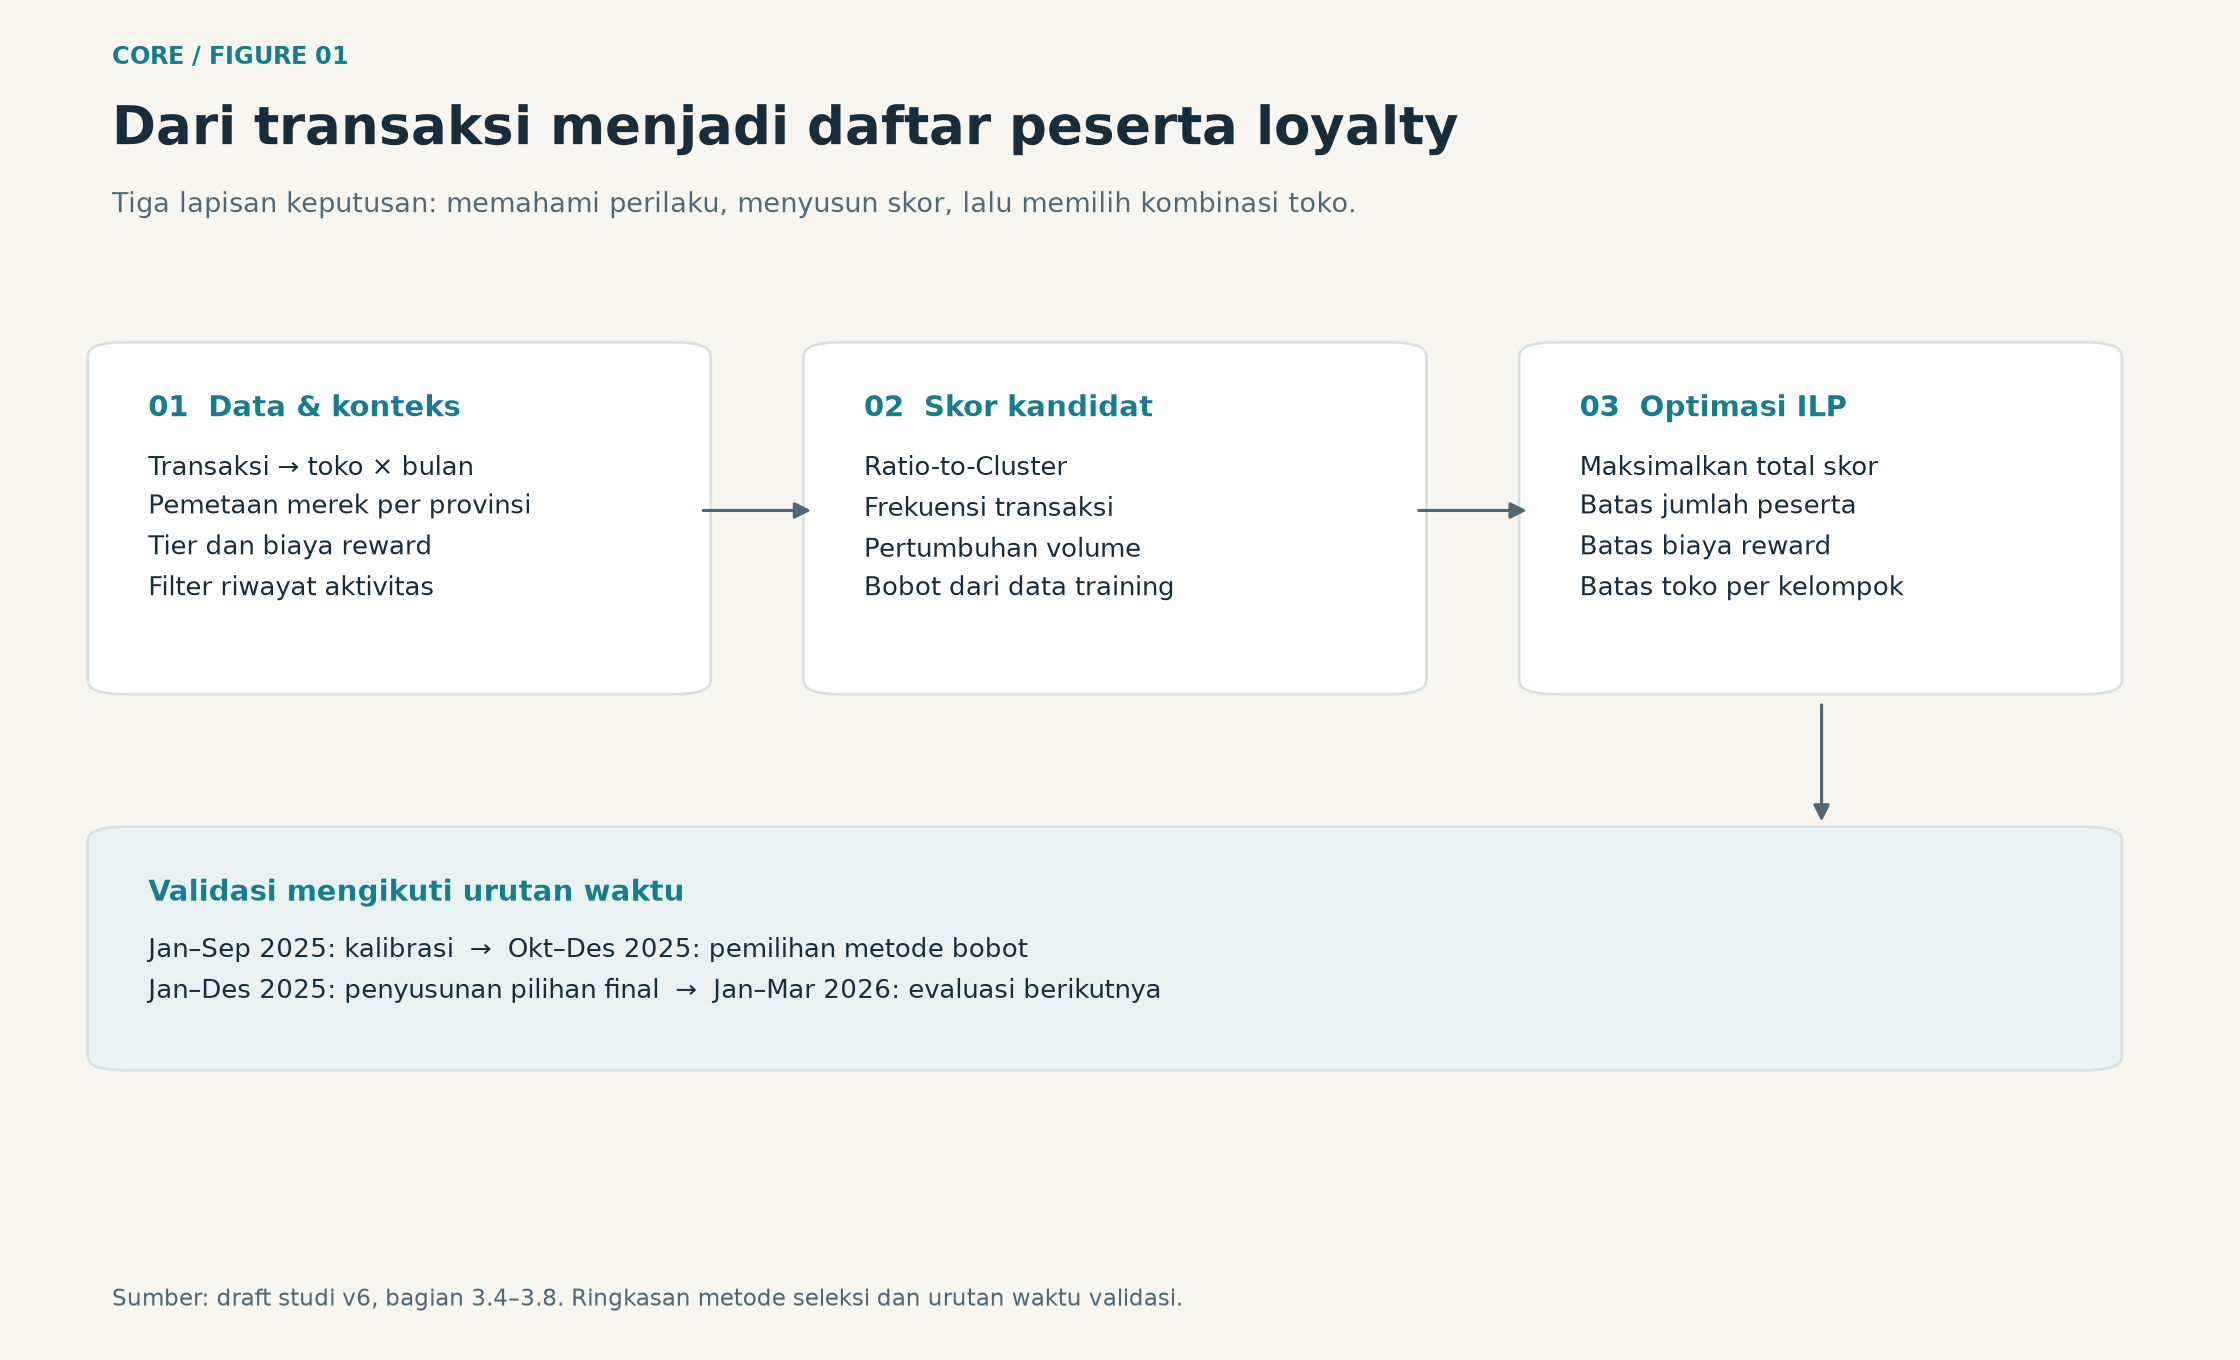
Langkah pertama adalah mengubah transaksi menjadi gambaran perilaku toko. Pembelian dijumlahkan per bulan, kemudian dirangkum pada tingkat toko. Dari sana, saya memakai tiga sudut pandang: volume relatif terhadap kelompoknya, frekuensi transaksi, dan perubahan volume pembelian.
Volume relatif membantu menempatkan toko dalam konteks yang lebih tepat. Sebuah toko Bronze bisa jauh lebih kuat daripada rata-rata kelompok Bronze, meskipun volume absolutnya masih di bawah toko Platinum. Perbandingan ini memberi ruang untuk menemukan kandidat yang kurang terlihat ketika seluruh toko hanya diurutkan berdasarkan tonase.
Frekuensi transaksi menambahkan konteks tentang keteraturan pembelian. Dua toko dengan volume bulanan yang hampir sama dapat memiliki pola berbeda: satu bertransaksi rutin, sedangkan yang lain bergantung pada beberapa pesanan besar. Perubahan volume kemudian membantu melihat apakah performa terbaru menguat atau melemah.
Saya juga memperhatikan toko yang tidak lagi bertransaksi pada akhir periode pengamatan. Jika analisis hanya mengambil bulan terakhir saat toko masih aktif, riwayat yang terlihat bisa terlalu optimistis. Bulan terakhir dalam periode pengamatan perlu tetap menjadi acuan agar ketidakaktifan tidak tersembunyi.
Ketiga indikator tersebut digabungkan menjadi skor. Untuk menentukan bobot, studi membandingkan beberapa pendekatan, termasuk korelasi Spearman yang membaca hubungan berdasarkan peringkat. Pemilihannya diuji menggunakan periode waktu berikutnya. Dengan begitu, bobot memiliki dasar evaluasi yang lebih jelas daripada sekadar perkiraan tentang indikator mana yang terasa paling penting.
Bagaimana transaksi berubah menjadi fitur
Secara teknis, saya memulai dari volume bulanan V(i,t) dan jumlah transaksi bulanan F(i,t). Untuk toko i, transaksi dijumlahkan pada setiap bulan t, lalu ringkasannya dihitung sepanjang periode training. Draft menggunakan jumlah bulan aktif sebagai penyebut rata-rata. Artinya, ukuran tersebut perlu dibaca sebagai intensitas pada bulan aktif; hasilnya dapat berbeda dari rata-rata yang membagi seluruh 12 bulan kalender.
| Fitur | Perhitungan dalam studi | Pertanyaan yang dijawab |
|---|---|---|
Avg_Ton | Jumlah volume selama training / jumlah bulan aktif | Seberapa besar pembelian pada bulan aktif? |
Avg_Trx | Jumlah transaksi selama training / jumlah bulan aktif | Seberapa sering toko bertransaksi saat aktif? |
Ratio | Avg_Ton toko / rata-rata Avg_Ton kelompoknya | Seberapa kuat toko dibandingkan kelompok yang sama? |
Growth | (volume bulan akhir − Avg_Ton) / Avg_Ton | Apakah pembelian bulan terakhir berada di atas atau di bawah rata-rata? |
Estimated_Cost | Jumlah volume rata-rata per peran merek × indeks reward yang sesuai | Berapa estimasi beban reward toko? |
Toko memerlukan setidaknya tiga bulan aktif untuk memenuhi syarat riwayat dalam studi. Pada fitur Growth, bulan akhir mengacu pada akhir jendela training, termasuk jika volume toko pada bulan itu nol. Data yang belum masuk perlu dibedakan dari bulan lengkap yang memang tidak memiliki transaksi.
Definisi tersebut juga menjelaskan batas istilah “pertumbuhan” di sini. Growth membandingkan bulan akhir dengan rata-rata historis; ia tidak sama dengan pertumbuhan year-on-year atau kemiringan tren sepanjang tahun.
Scoring yang dapat dihitung kembali
Bobot Spearman yang tercatat dalam draft adalah 0,4775 untuk Ratio, 0,4186 untuk frekuensi transaksi, dan 0,1039 untuk pertumbuhan. Formula skornya:
norm(z) = (z − minimum_training) / (maksimum_training − minimum_training + ε)

S(i) = 0,4775 × Ratio(i)
     + 0,4186 × norm(Avg_Trx(i))
     + 0,1039 × norm(Growth(i))
ε adalah nilai kecil untuk menghindari pembagian dengan nol. Parameter normalisasi dihitung dari data training, sehingga informasi periode evaluasi tidak ikut membentuk skor sebelumnya.
Sebagai contoh ilustratif, sebuah toko memiliki Ratio = 1,20, frekuensi ternormalisasi 0,60, dan pertumbuhan ternormalisasi 0,10. Skornya menjadi 0,57300 + 0,25116 + 0,01039 = 0,83455. Angka contoh ini dibuat untuk menjelaskan formula, bukan identitas atau hasil toko perusahaan.
Ada detail yang mudah terlewat: Ratio pada formula sumber tidak diberi normalisasi min–max, sedangkan dua fitur lainnya dinormalisasi. Karena skalanya berbeda, koefisien 0,4775 tidak boleh dibaca sebagai “47,75% pengaruh aktual” untuk setiap toko. Kontribusi nyata tetap bergantung pada nilai fitur, dan skor tidak harus berada pada rentang 0–1. Rasio yang sangat besar perlu diperiksa agar tidak mendominasi tanpa disadari.
Dari skor toko menjadi kombinasi peserta
Setelah skor tersedia, pekerjaan belum selesai. Memilih peserta berarti menyusun satu kelompok toko yang harus berjalan dalam batasan program.
Ada jumlah peserta yang dapat ditangani, estimasi biaya reward, dan komposisi kelompok toko yang perlu dipertimbangkan. Peran merek juga berbeda antarwilayah. Merek yang menjadi andalan di satu provinsi dapat memiliki posisi berbeda di provinsi lain, sehingga pemetaan merek perlu mengikuti konteks wilayah saat biaya reward dihitung.
Saya menggunakan Integer Linear Programming, atau ILP, untuk mencari kombinasi peserta berdasarkan skor dan batasan tersebut. Secara sederhana, sistem mengevaluasi pilihan toko mana yang dimasukkan agar total skor sebaik mungkin, sambil memperhitungkan kapasitas dan aturan program.
Salah satu skenario yang diuji bernama ILP-A Mirror. Skenario ini memakai proporsi kelompok peserta yang sudah ada sebagai acuan batas jumlah toko per kelompok. Skenario lain memberi kelonggaran lebih besar, sampai batas komposisi kelompok dilepas.
Di sinilah muncul pelajaran yang menarik. Dalam hasil studi, mengejar skor gabungan yang lebih tinggi tidak selalu menghasilkan kelompok peserta dengan volume pembelian lebih baik. Ketika komposisi terlalu bebas, pilihan dapat terkonsentrasi pada kelompok tertentu. Aturan bisnis yang dimasukkan ke model ternyata memengaruhi kualitas rekomendasinya.
Temuan ini mengubah cara saya melihat optimasi. Memahami batasan bisnis merupakan bagian dari merancang model yang berguna. Pertanyaan tentang anggaran dan keseimbangan peserta perlu dijawab sejak awal, karena keduanya menentukan seperti apa pilihan yang layak dijalankan.
Menerjemahkan aturan program menjadi batas matematis
Setiap kandidat memiliki variabel biner x(i): bernilai 1 jika dipilih dan 0 jika tidak. Model kemudian dirumuskan sebagai berikut:
Tujuan:
  maksimalkan Σ S(i) × x(i)

Dengan batas:
  Σ x(i) ≤ N_max
  Σ C(i) × x(i) ≤ B
  Σ x(i) untuk toko di kelompok k ≤ ceil(λ × a(k) × N_max)
  x(i) ∈ {0, 1}
C(i) adalah estimasi biaya reward, B batas anggaran, dan a(k) proporsi kelompok pada daftar acuan dalam bentuk pecahan, misalnya 0,20 untuk 20%. λ menentukan kelonggaran batas kelompok. Jika proporsi disimpan sebagai angka persen seperti pada draft, formula perlu dibagi 100. ceil berarti pembulatan ke atas.
| Skenario | Nilai λ | Arti operasional |
|---|---|---|
| ILP-A Mirror | 1,00 | Batas jumlah per kelompok mengikuti proporsi daftar acuan |
| ILP-B Relaxed | 1,50 | Batas per kelompok diperlonggar 50% |
| ILP-C Unconstrained | Batas kelompok dilepas | Batas jumlah dan biaya tetap ada; yang dilepas hanya batas komposisi |
Nama “Mirror” perlu dibaca sesuai rumus. Batas atas per kelompok dan batas total peserta tidak memaksa komposisi akhir identik dengan daftar lama. Komposisi aktual tetap bergantung pada jumlah yang terpilih dan batas lain yang aktif.
Dalam studi, formulasi diselesaikan dengan PuLP dan solver CBC. PuLP digunakan untuk menyatakan variabel, tujuan, serta constraint; solver mencari solusi dari model tersebut. Pola pemisahan ini juga dijelaskan dalam dokumentasi resmi PuLP.
Untuk menjelaskan perhitungan biaya, bayangkan toko membeli rata-rata 20 ton merek utama dan 10 ton merek pendamping per bulan. Dengan indeks reward ilustratif masing-masing 100 dan 50, estimasi biayanya adalah 20 × 100 + 10 × 50 = 2.500 unit indeks. Pemetaan peran merek per provinsi memastikan volume masuk ke kategori biaya yang sesuai. Angka ini bukan nominal rupiah.
Kualitas implementasi perlu diperiksa setelah solver selesai: status solusi, jumlah peserta, biaya total, serta jumlah toko tiap kelompok harus dihitung ulang dari daftar keluarannya. Solusi yang dilaporkan optimal pun tetap perlu diuji terhadap data dan batas yang benar-benar dipakai.
Menguji pilihan pada periode berikutnya
Rekomendasi yang terlihat menarik pada data lama perlu diperiksa pada periode yang belum dipakai untuk menyusun pilihan. Dalam studi ini, seleksi berbasis data 2025 dievaluasi menggunakan transaksi Januari–Maret 2026.
Hasil evaluasi yang tercatat dalam draft studi menunjukkan bahwa kelompok toko hasil seleksi ILP-A Mirror memiliki rata-rata volume bulanan per toko sekitar 8,35% lebih tinggi daripada kelompok seleksi manual pada periode tersebut.
Membaca hasil lengkap, termasuk metode pembanding
Berikut nilai deskriptif pada Tabel 12 draft. n adalah jumlah toko yang tercatat dalam evaluasi masing-masing metode; kelompoknya dapat saling tumpang tindih.
| Metode | n evaluasi | Rata-rata ton/toko/bulan | Selisih terhadap manual |
|---|---|---|---|
| Top-N Tonnage | 1.686 | 226,54 | +40,68% |
| ILP-A Mirror | 1.583 | 174,48 | +8,35% |
| Manual Existing | 1.730 | 161,03 | Acuan |
| ILP-B Relaxed | 1.696 | 157,99 | −1,89% |
| Greedy | 1.669 | 151,16 | −6,13% |
| ILP-C Unconstrained | 1.673 | 151,08 | −6,18% |
Selisih dihitung dari rata-rata yang ditampilkan, dengan rumus (rata-rata metode / 161,03 − 1) × 100%. Tidak ada interval ketidakpastian yang direka untuk grafik ini.
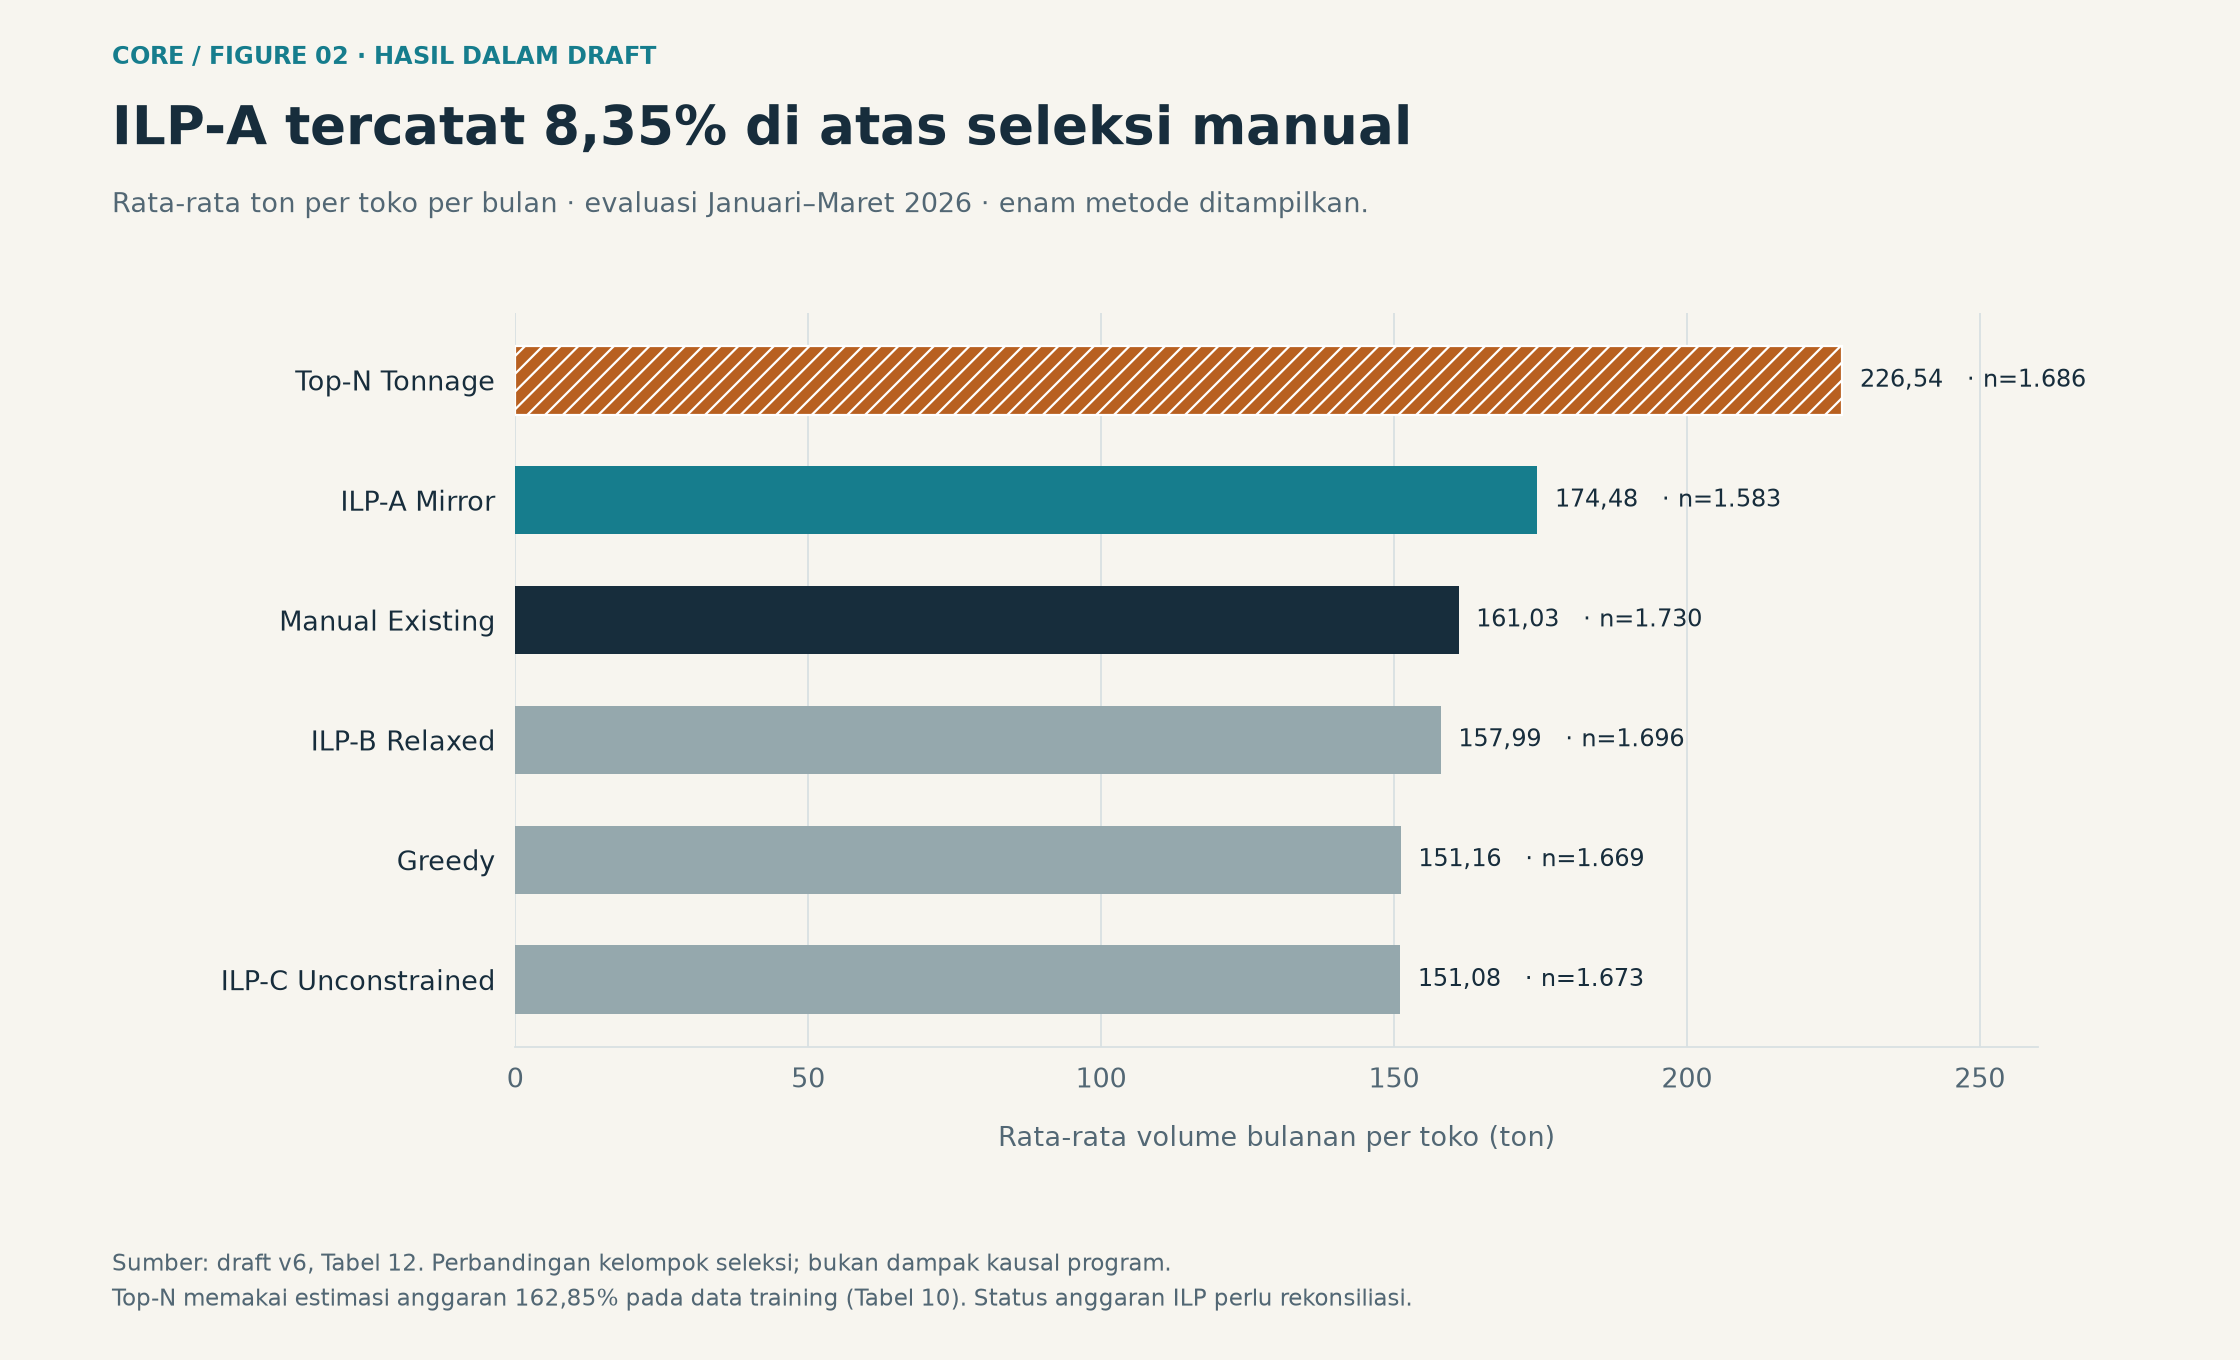
Perbandingan biaya masih memerlukan rekonsiliasi. Tabel 10 mencatat penggunaan anggaran ILP-A 101,03%, sementara formulasi menetapkan batas 100%. Tanpa pemeriksaan denominator, perhitungan biaya, dan keluaran solver, angka itu belum mendukung klaim bahwa batas anggaran sudah dipenuhi. Karena itu, hasil performa dan kepatuhan terhadap constraint harus dibaca sebagai dua pemeriksaan terpisah.
Angka itu menunjukkan perbedaan performa kelompok toko hasil dua metode seleksi. Angka tersebut belum mengukur kenaikan penjualan akibat program loyalty atau dampak penerapan CORE dalam operasional perusahaan. Untuk mengukur dampak itu, dibutuhkan evaluasi intervensi yang mempertimbangkan kondisi sebelum program, kelompok pembanding, dan perubahan pasar.
Hasilnya juga memiliki lingkup yang jelas: satu distributor dan tiga bulan evaluasi setelah periode penyusunan model. Karena itu, saya melihatnya sebagai bukti awal tentang kualitas seleksi dalam konteks studi ini, dengan kebutuhan pengujian lanjutan pada periode yang lebih panjang.
Ada eksperimen lain yang sama bergunanya. Penyesuaian skor menggunakan ukuran sederhana ketidakaktifan toko mengubah cukup banyak peserta, tetapi belum memberikan peningkatan performa yang meyakinkan dibandingkan model awal. Hasil seperti ini membantu menentukan fitur mana yang memang perlu dipertahankan.
Seberapa mudah daftar peserta berubah
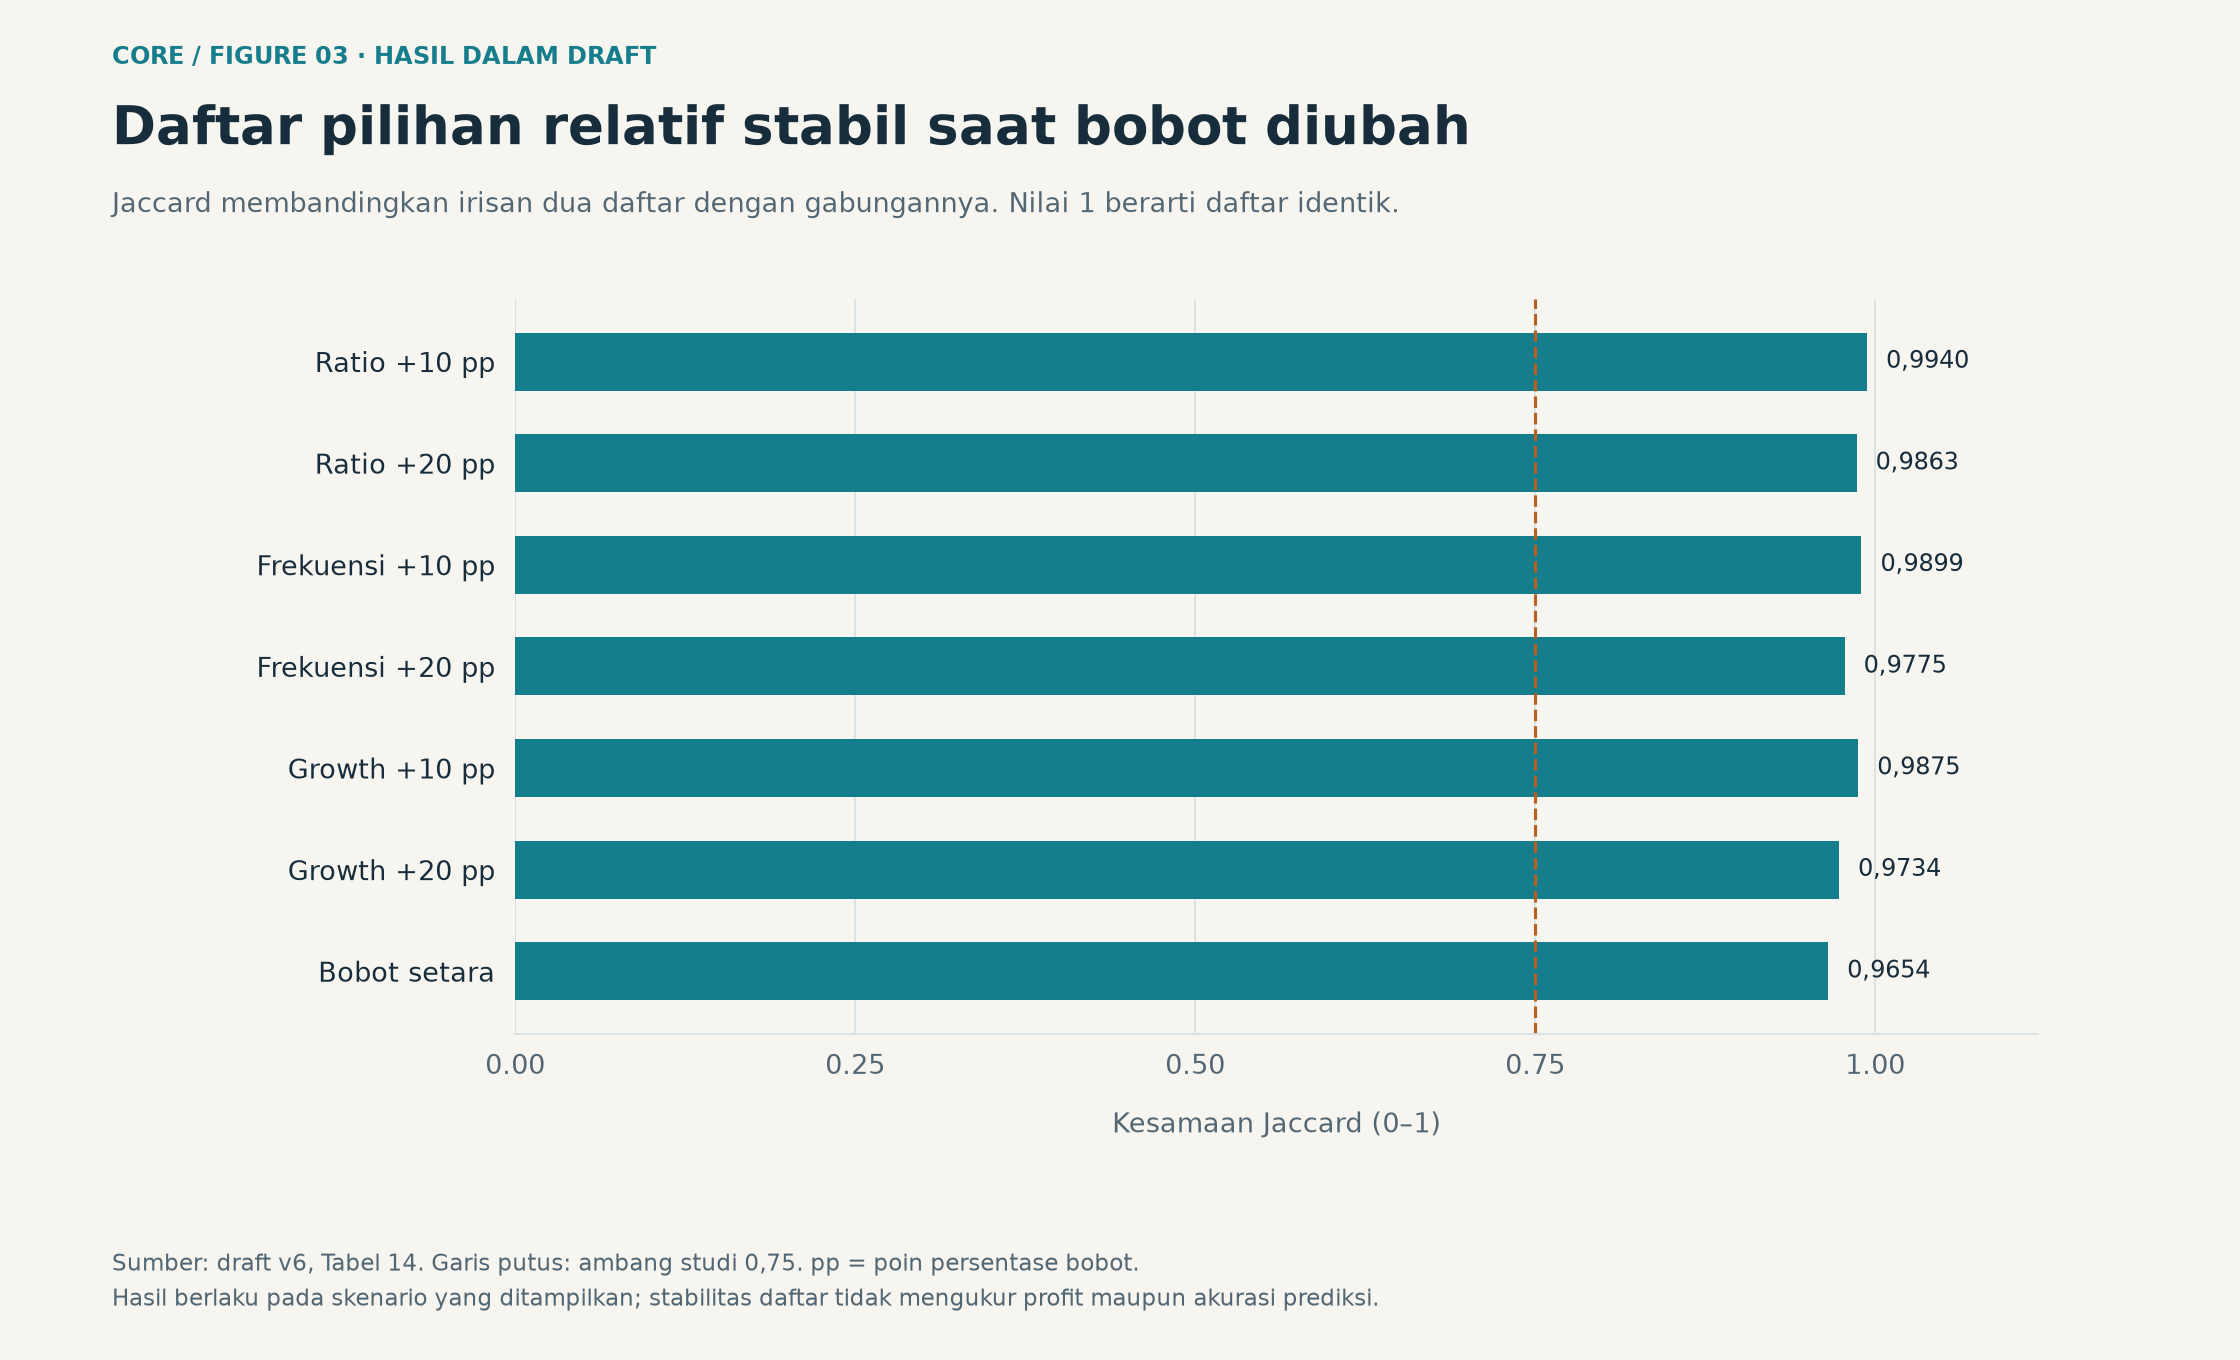
Stabilitas diuji dengan mengubah bobot kemudian membandingkan daftar baru dengan daftar awal. Ukurannya adalah Jaccard: jumlah toko pada irisan kedua daftar / jumlah toko pada gabungan kedua daftar.
| Skenario perubahan bobot | Jaccard terhadap daftar awal |
|---|---|
| Ratio +10 pp | 0,9940 |
| Ratio +20 pp | 0,9863 |
| Frekuensi +10 pp | 0,9899 |
| Frekuensi +20 pp | 0,9775 |
| Growth +10 pp | 0,9875 |
| Growth +20 pp | 0,9734 |
| Bobot setara | 0,9654 |
Kesamaan yang tinggi memberi informasi bahwa daftar tidak banyak berubah pada skenario tersebut. Ia tidak mengukur akurasi prediksi, keuntungan program, atau ketahanan terhadap seluruh kemungkinan perubahan pasar.
Untuk evaluasi lanjutan, penyebut rata-rata perlu dikunci secara konsisten, toko yang tidak aktif pada periode evaluasi tetap perlu ditelusuri, dan kelompok yang saling tumpang tindih perlu diperlakukan dengan benar saat pengujian statistik. Langkah tersebut membantu memastikan bahwa keunggulan per toko tidak muncul hanya karena perbedaan cakupan evaluasi.
Menempatkan optimasi di dalam CORE
Modul seleksi loyalty memberi CORE kemampuan untuk menjawab pertanyaan tentang alokasi: toko mana yang layak diprioritaskan, dengan batasan apa, dan atas dasar apa?
Namun, keputusan komersial juga membutuhkan pemahaman tentang perubahan kondisi pasar. Toko yang sebelumnya kuat bisa mulai menunjukkan pola pembelian yang berbeda. Karena itu, pengembangan CORE juga mencakup AEGIS untuk membaca sinyal awal, pengelolaan loyalty untuk menyiapkan tindakan, serta pemantauan performa untuk meninjau perkembangan setelah tindak lanjut.
Bagi saya, bagian paling berharga dari proyek ini adalah membuat keputusan yang sebelumnya sulit dijelaskan menjadi lebih mudah dibahas. Tim bisa melihat alasan sebuah toko direkomendasikan, membandingkan skenario, lalu menambahkan pengetahuan lapangan sebelum mengambil keputusan.
Jika sedang mengevaluasi program loyalty, pertanyaan awal yang berguna adalah: apakah daftar peserta saat ini masih mencerminkan perilaku toko terbaru? Dari pertanyaan itu, data transaksi dapat membantu membuka kembali pilihan yang selama ini dianggap sudah tepat.
Lihat pengembangan platform dan modul lainnya di portfolio CORE.